04 Transformers, Attention, and FlashAttention
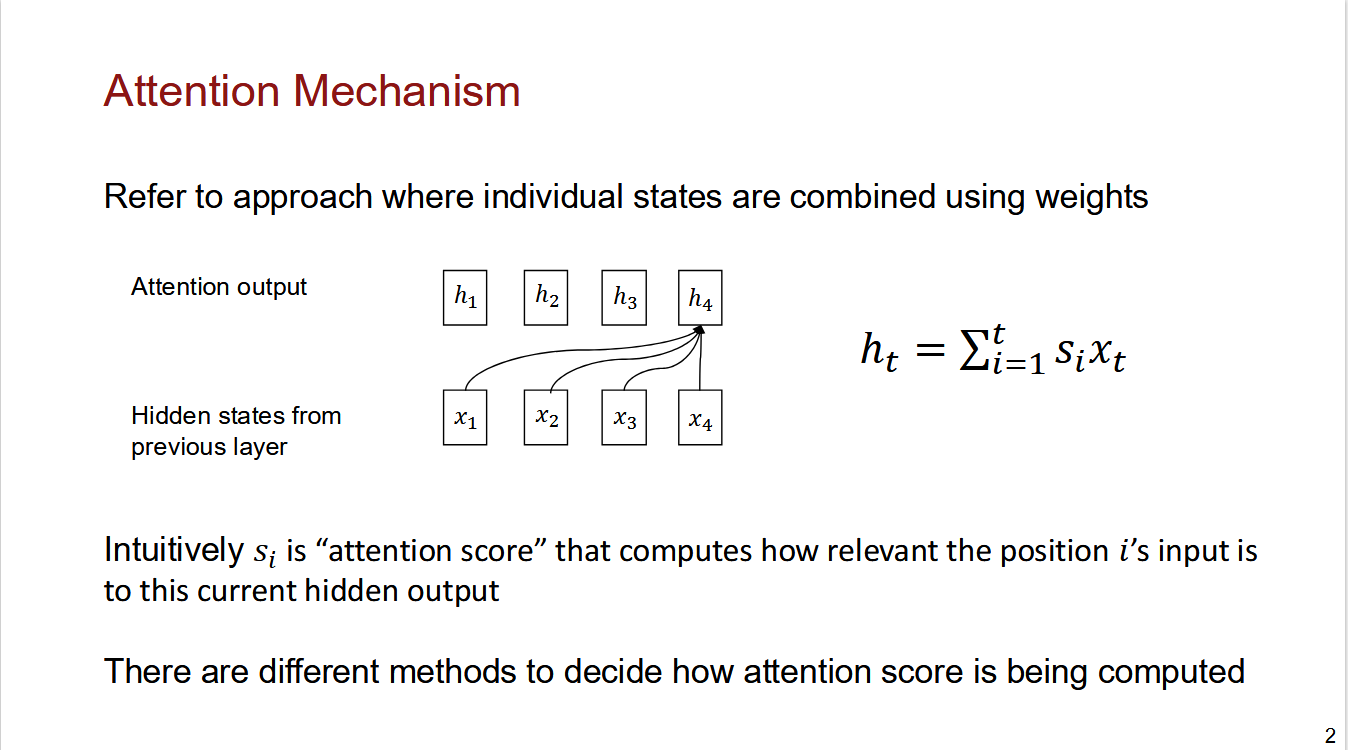
注意力机制的核心是加权求和。
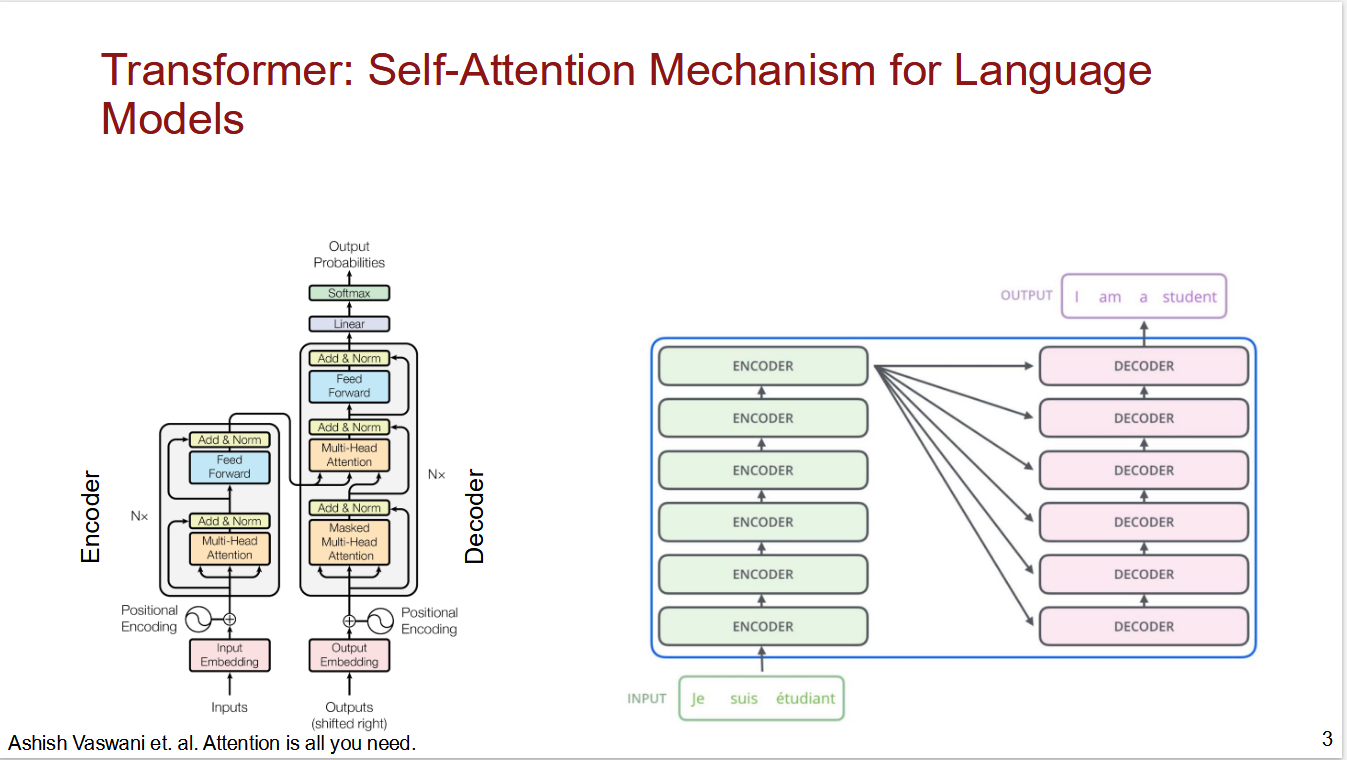
原始的 Transformer 论文面向翻译任务,我个人认为重点是 Self-Attention、Multi-Head Attention 两个机制和 Encoder-Decoder 的整体架构。这两个机制也是接下来讨论的重点。
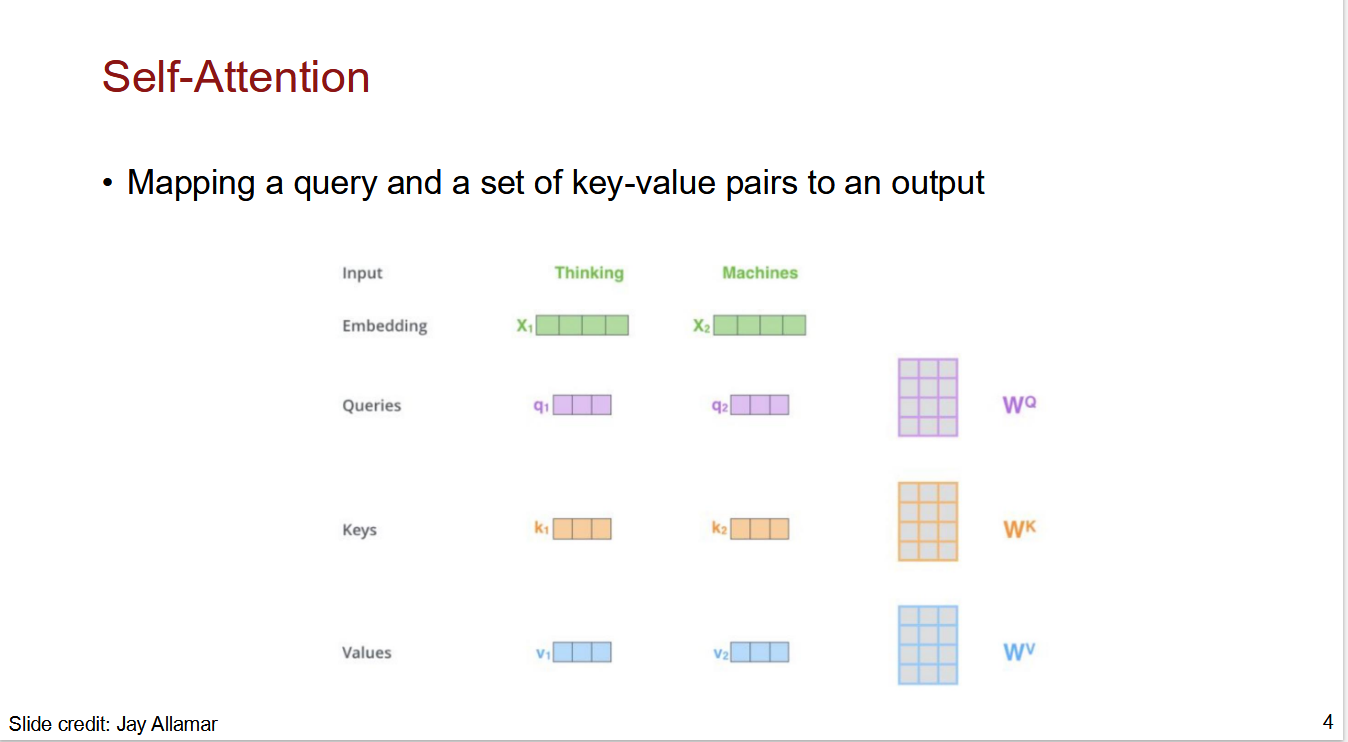
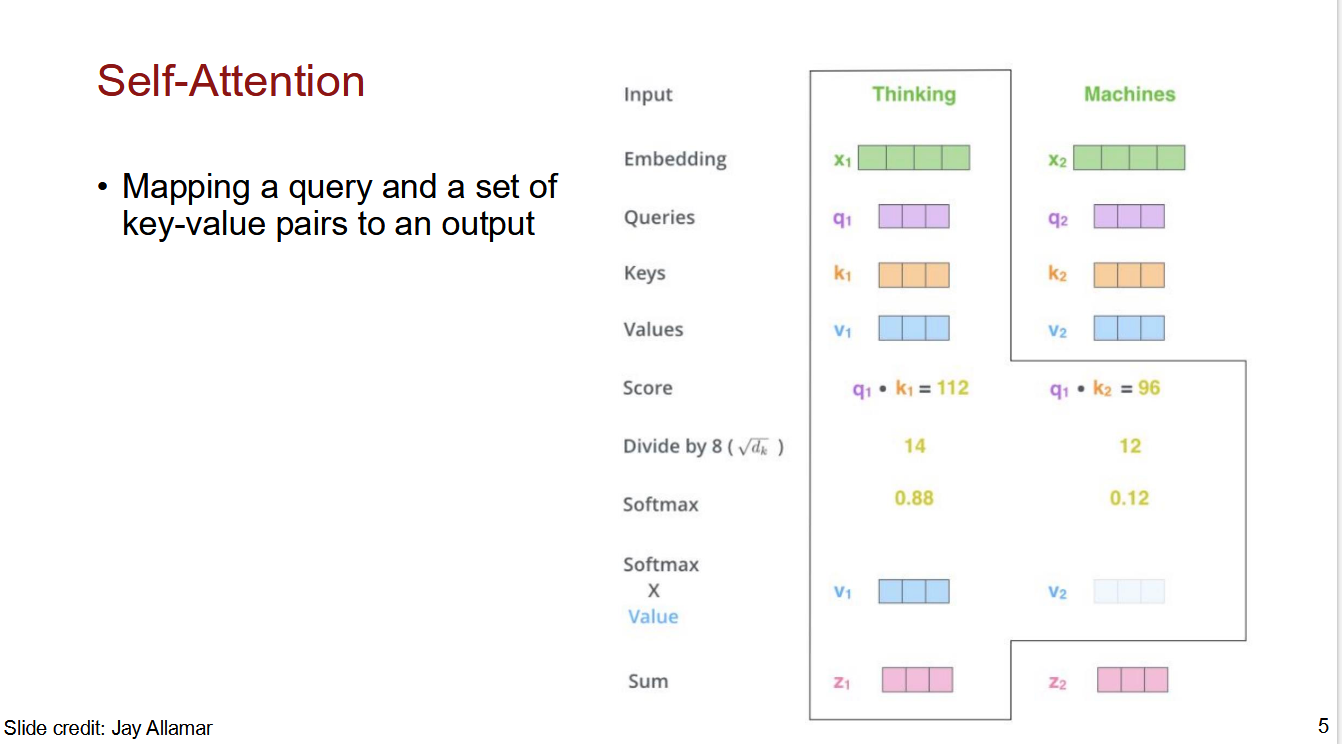
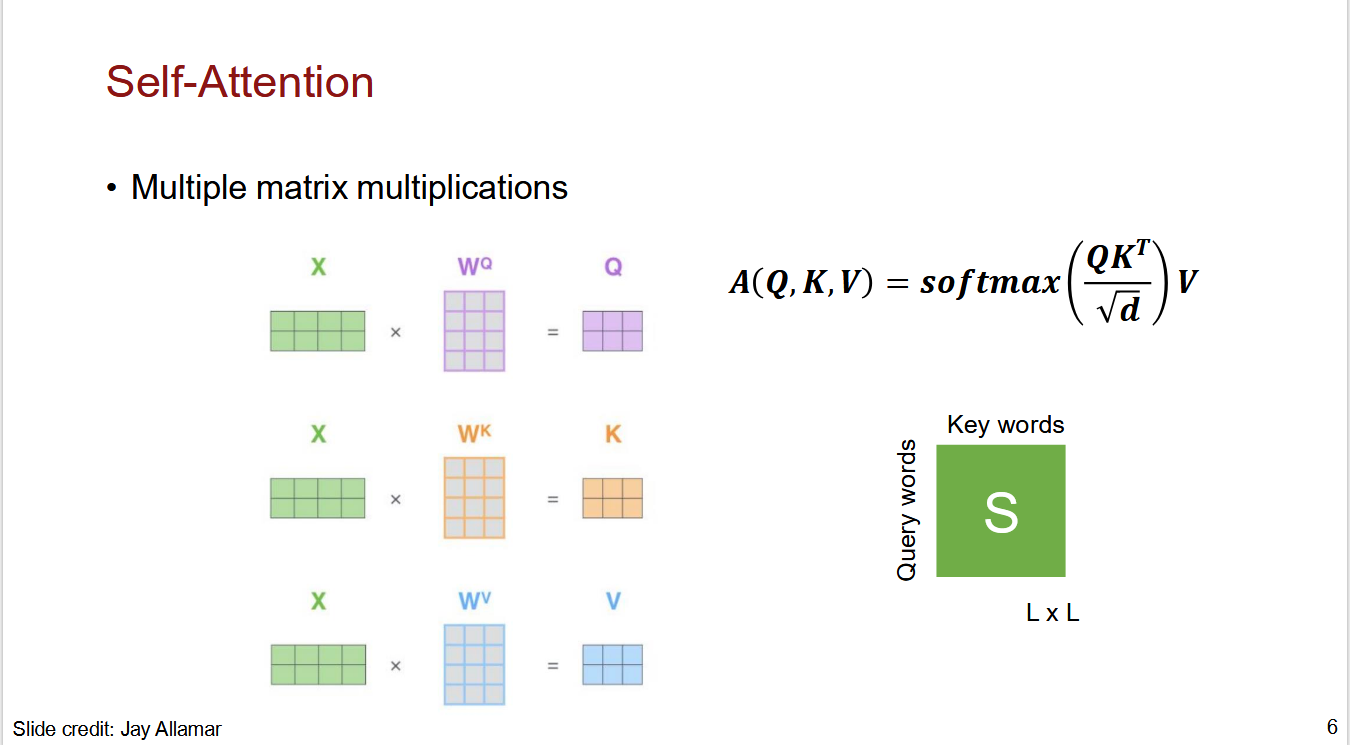
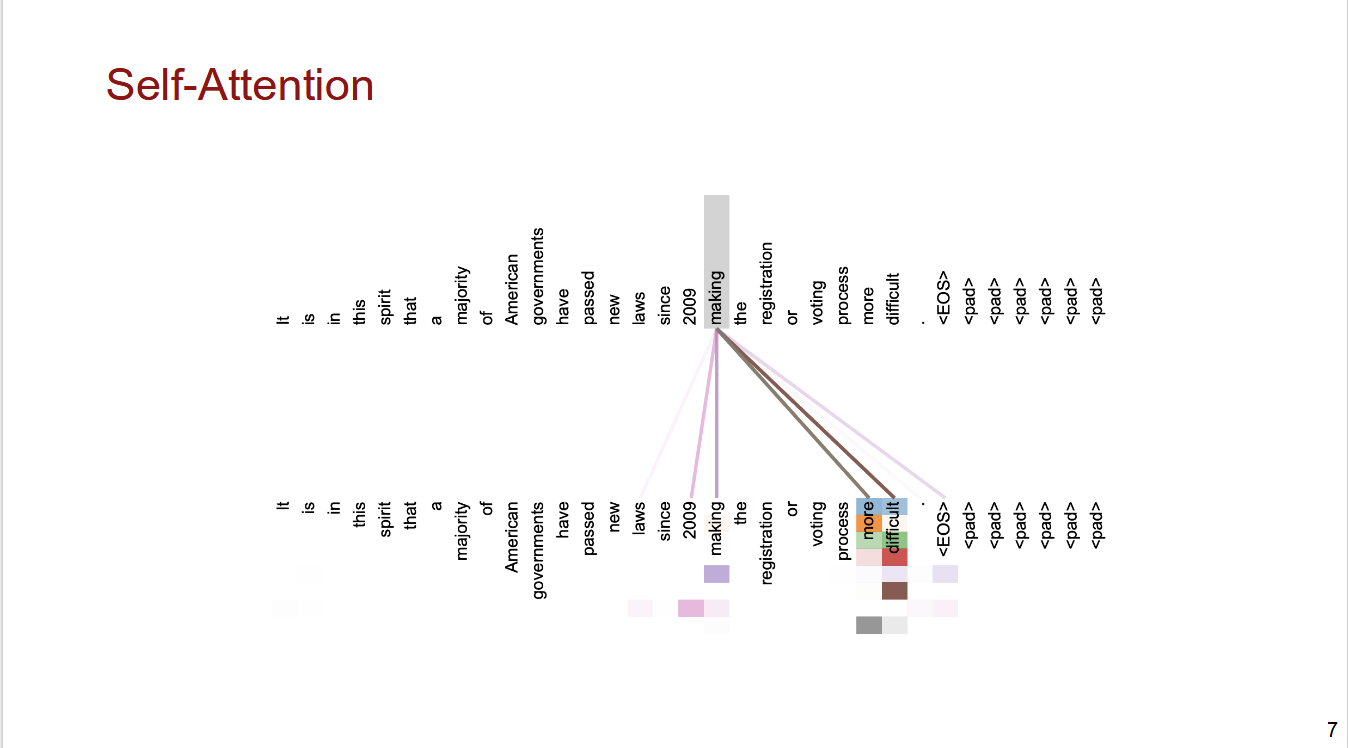
Self-Attention 描述了这样的过程:用户输入了一句话,模型会把这句话拆分成若干 token,通过 token ID 映射到若干 embedding。这若干 embedding 会乘上权重矩阵
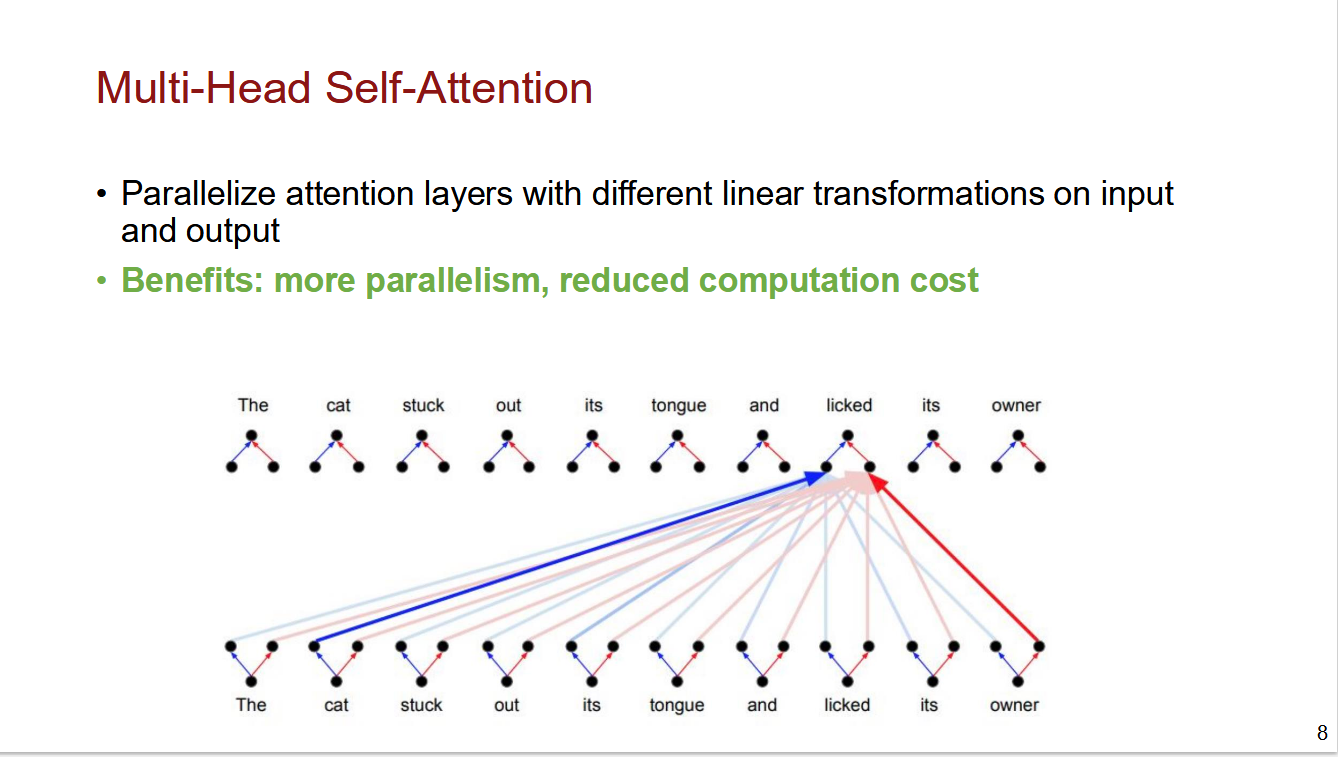
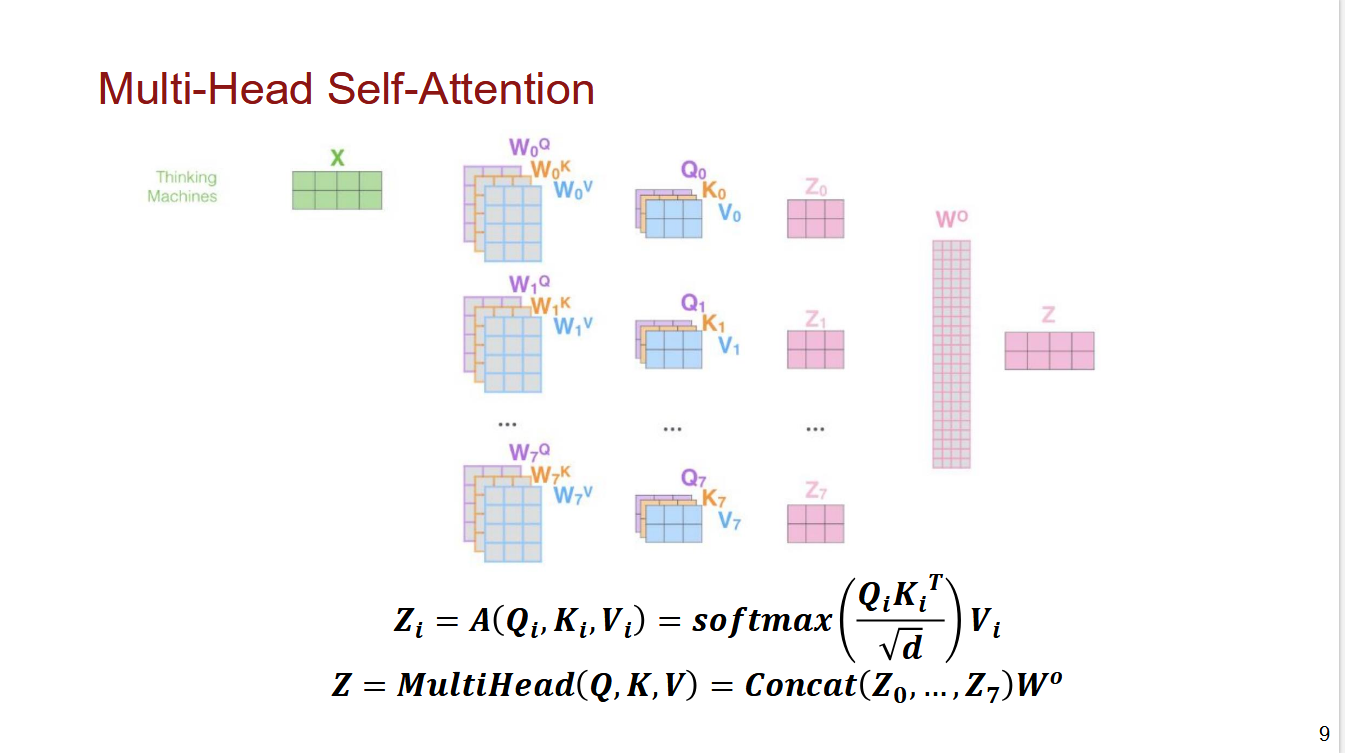
Multi-Head Attention 将 Self-Attention 的过程重复了
现有的生成式语言模型主要采用 Decoder-Only 架构。在 Decoder-Only 架构中,推理过程天然分为两个阶段:Prefill 阶段把输入的 prompt 处理成 Key、Value,生成第一个 token;Decode 阶段把前面生成的 token 作为输入,继续生成下一个 token,这个推理过程是自回归的。
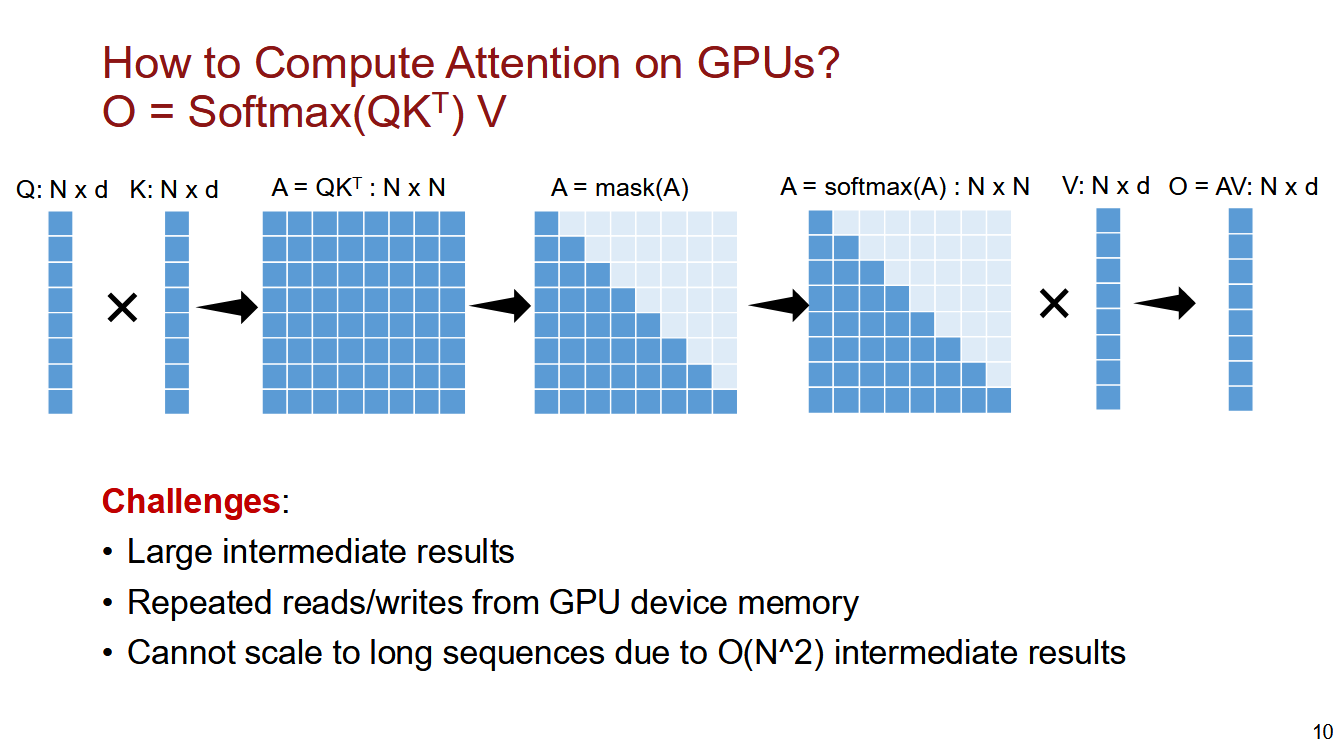
图中展示了一个朴素的
- 庞大的中间结果:
的中间结果是一个 的矩阵, 是序列长度。对于长序列, 很大,这个中间结果会占用大量显存。 - 重复的内存访问:数据会反复在 Shared Memory 和 Global Memory 之间传输,导致性能下降。
- 不可扩展性:复杂度是
。
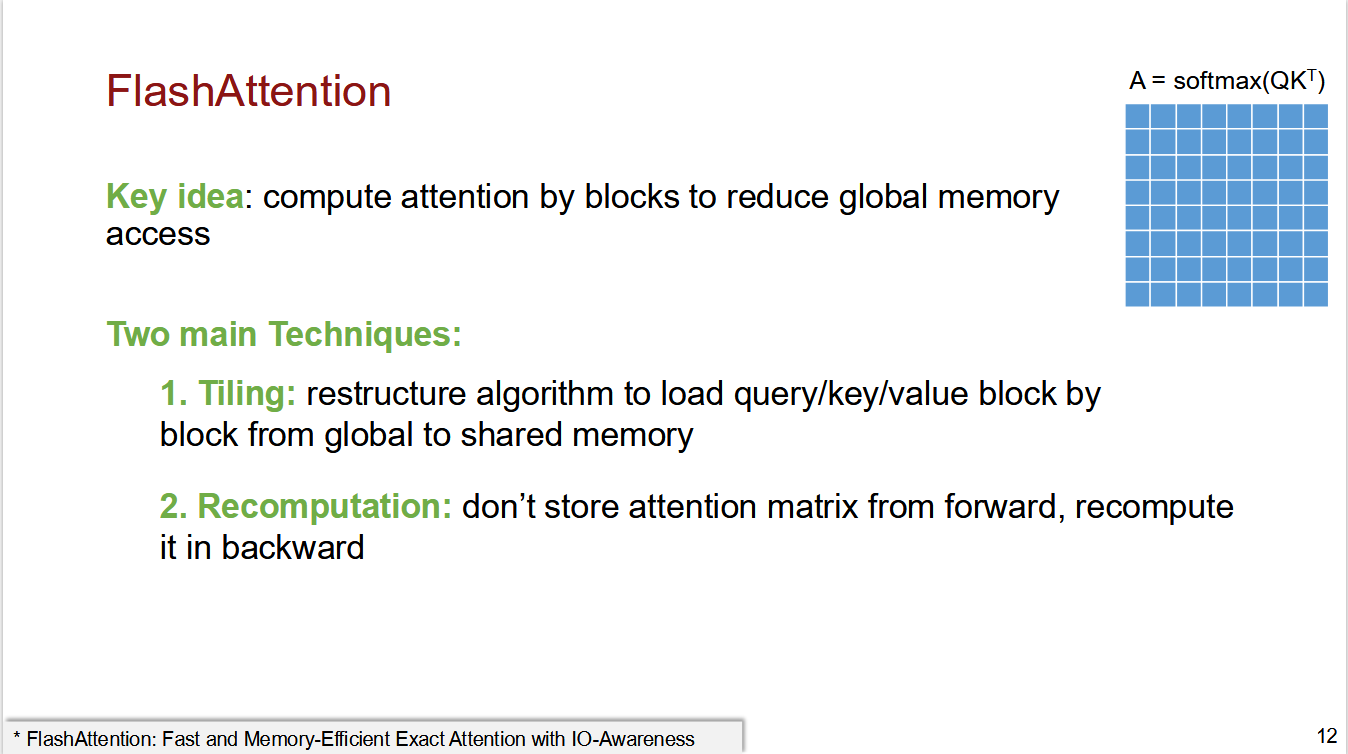
Flash Attention 的目的是解决内存 IO 带来的性能问题(并非对 Attention 机制本身做轻量化改造),核心思想是按块(Block)计算注意力分数和加权求和。两个主要的技术:
- Tiling:分块重构计算过程。
- Recomputation:在计算过程中,舍弃中间结果,按需重新计算。
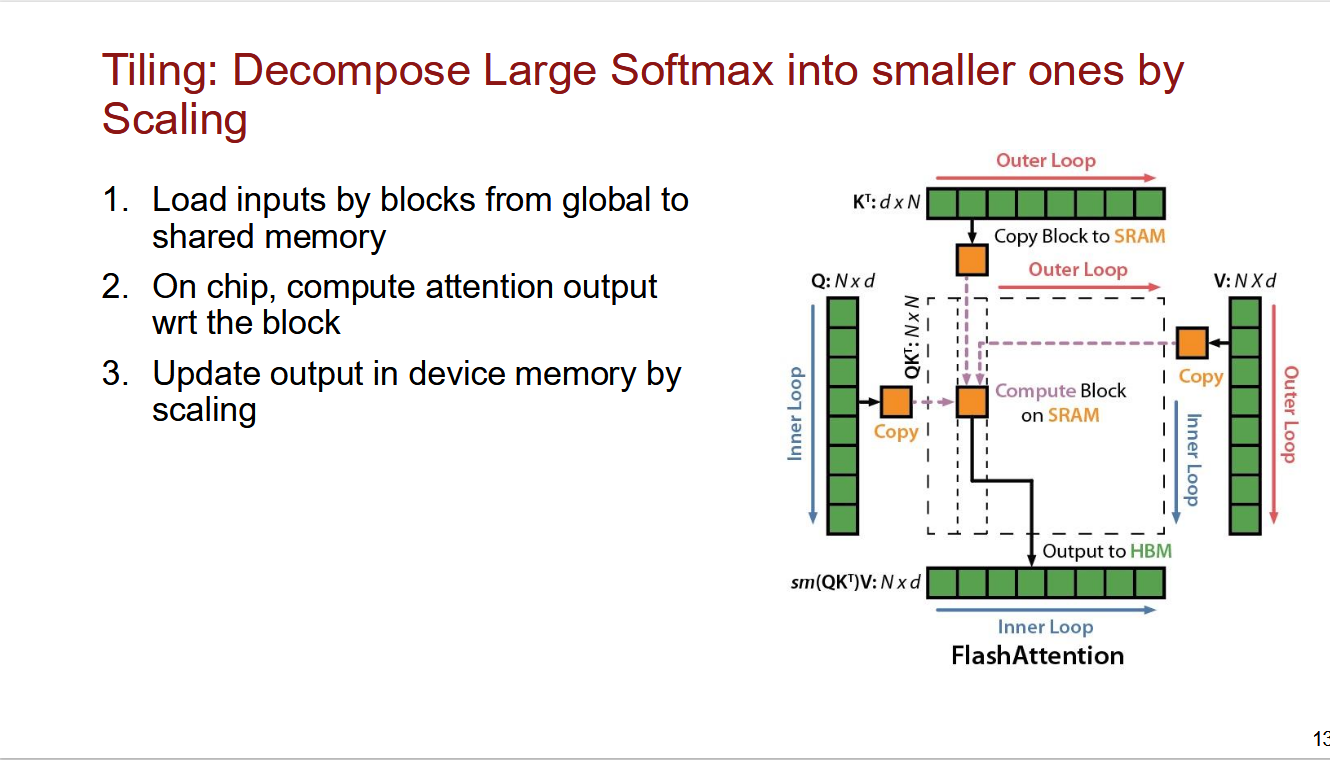
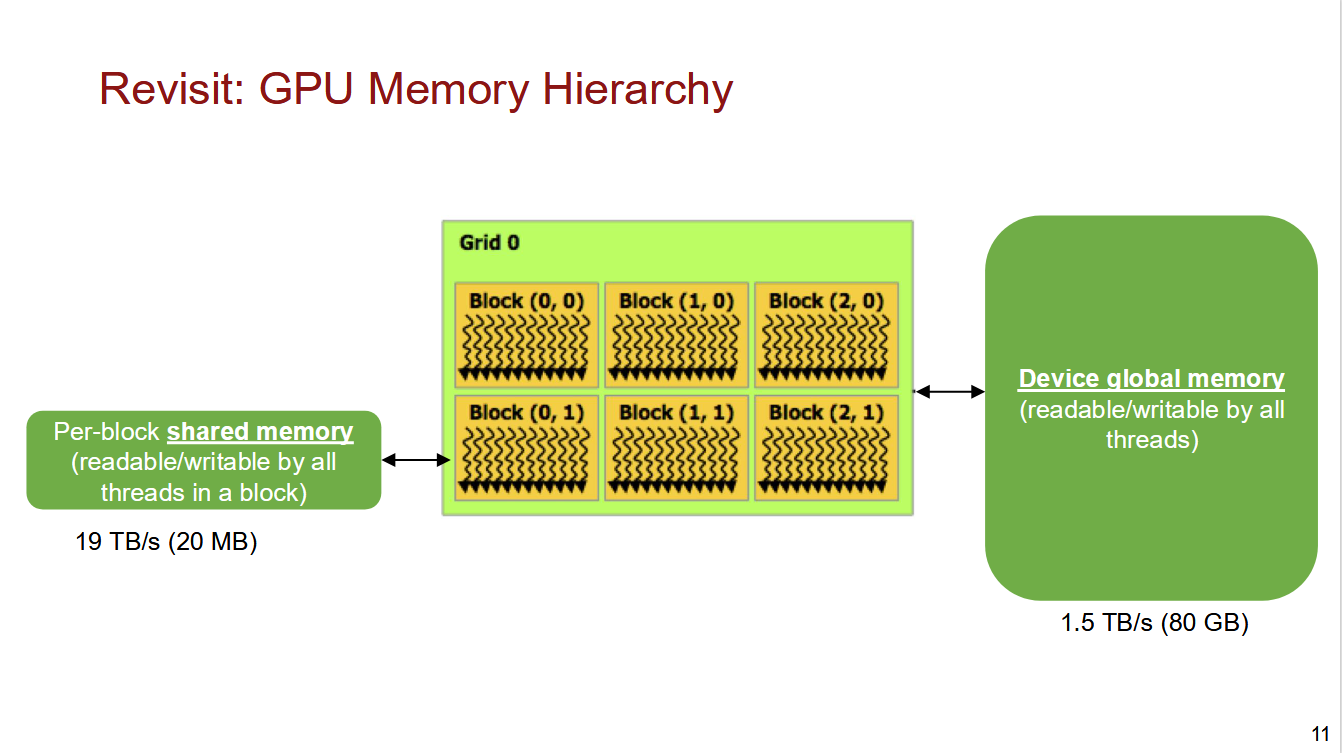
- 不把整个 Q,K,V 留在 HBM 里做计算,而是切成橙色的 Block,按需搬运到 SRAM。
- 对于加载进来的
和 ,直接在片上算出局部注意力分数 ,紧接着做局部的 softmax 和与 的加权,得到该块对最终输出的局部贡献。 - 因为 softmax 是全局归一化操作,单独对这个子块做 softmax 得到的归一化系数是"局部"的,不是全局正确的。因此,每处理一个新块,必须通过一个 scaling 操作,把之前累积的中间结果按新的统计量(全局最大值、全局指数和)重新校正,再写入 HBM 中的输出。
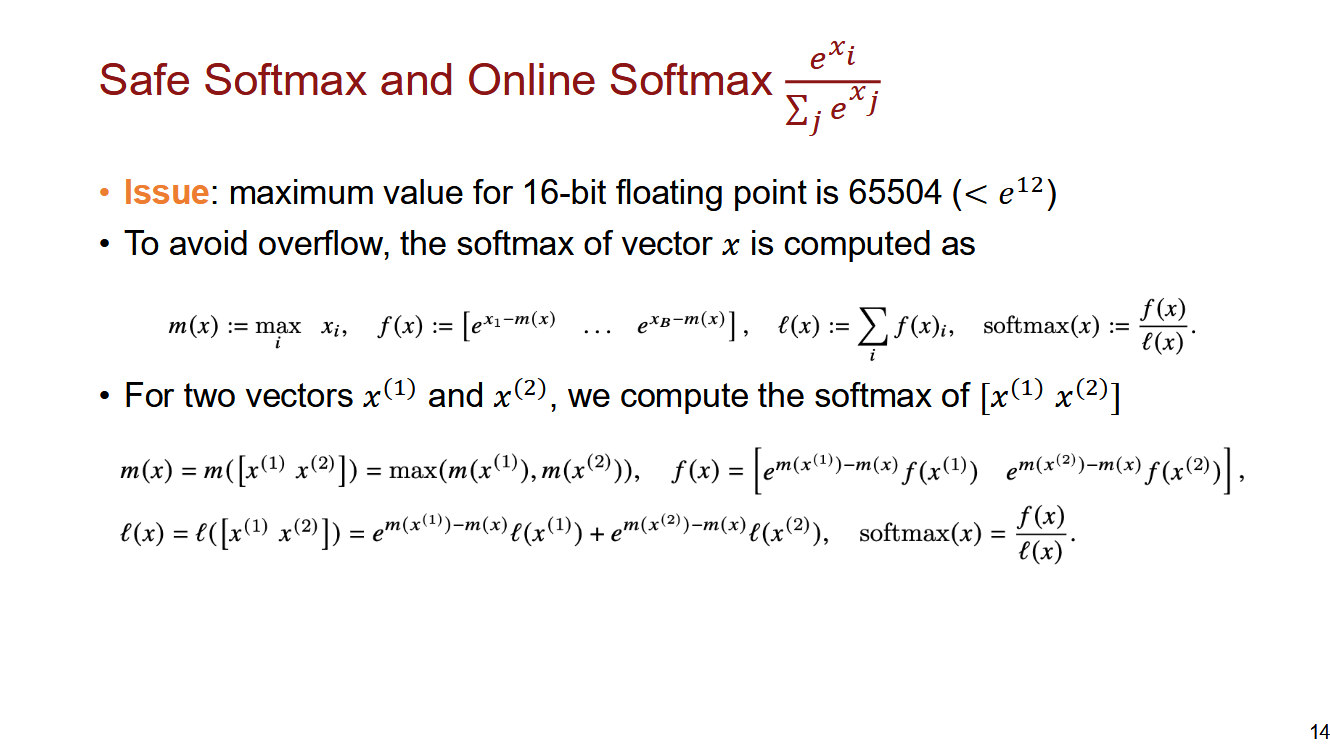
Safe Softmax 用于避免上溢风险;Online Softmax 则是处理上面提到的局部归一化问题。只要维护当前见过的最大值
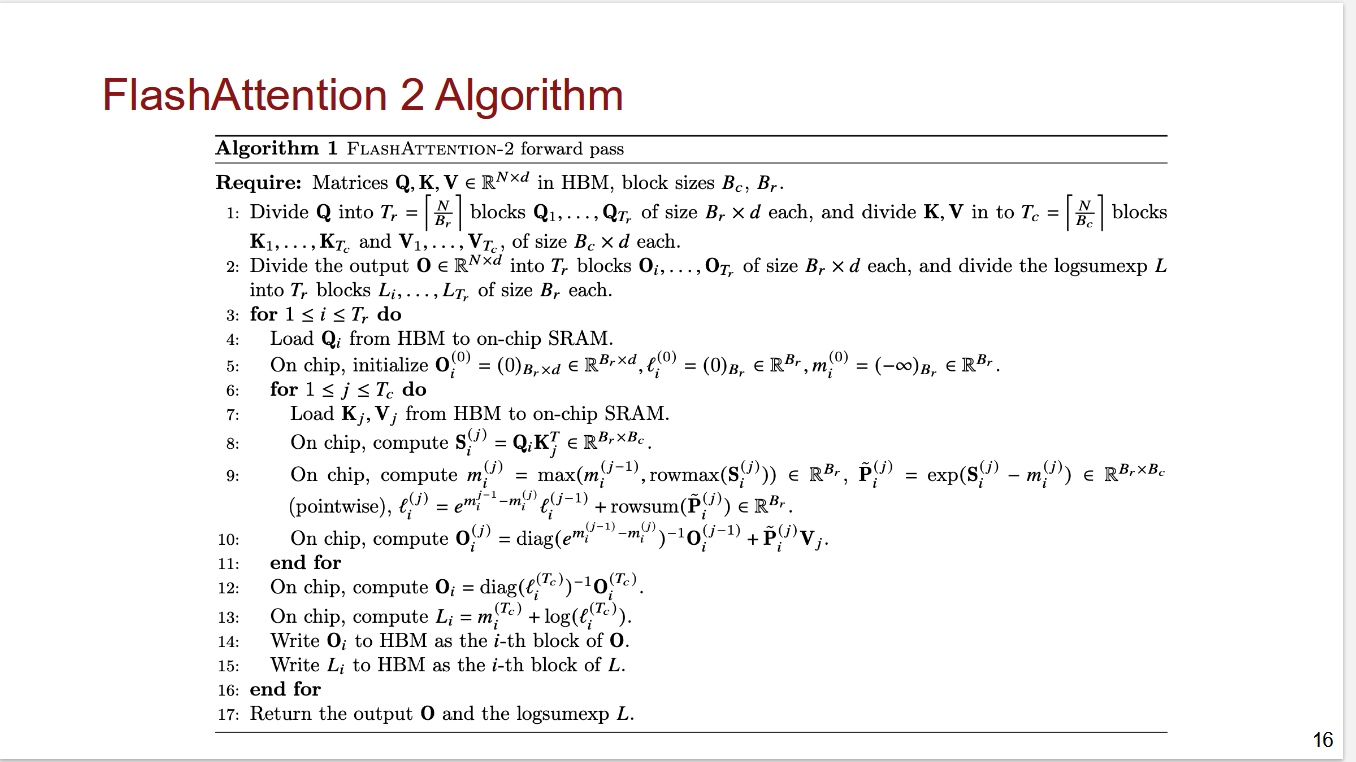
Flash Attention-2 的算法如上。
Require: Matrices
in HBM, block sizes . 1: Divide
into blocks of size each, and divide in to blocks and , of size each. Not a source quote
按行切成 块(每块 个 query),因为输出 也是按 query 的行方向对应。 按行切成 块(每块 个 key/value),因为 Attention 的本质是 query 与所有 key 交互。 - 所有原始数据一开始都在慢速的 HBM 里。
3: for
do 4: Load from HBM to on-chip SRAM. 5: On chip, initialize , , . Not a source quote
外层循环遍历每个 query 块
| 状态 | 维度 | 含义 |
|---|---|---|
| 未归一化的输出累加器。里面存的是截至第 | ||
| 修正后的指数和累加器。截至当前见过的所有 key 块,按全局最大值调整后的 | ||
| 当前见过的全局最大值。每一行(每个 query)单独维护一个最大值,因为 softmax 是按行归一化的。 |
初始值
6:
for do 7: Load from HBM to on-chip SRAM. 8: On chip, compute . Not a source quote
内层循环遍历所有 key/value 块。每次只从 HBM 取一个
注意:这个
9:
On chip, compute , (pointwise), .
这是算法的数学心脏,对应前面讲的 Online Softmax 合并公式:
- 更新全局最大值:把上一个循环的
与新块 的每行最大值比较,得到截至目前的真实全局最大值 。 - 计算局部未归一化概率
:用新的全局最大值去减,保证指数始终 ,既数值安全(Safe Softmax),又确保新旧块在同一基准下。 - 修正并累加指数和
:旧的 是相对于 计算的,现在基准变成了更大的(或相等的) ,所以必须乘以缩放因子 才能加到新的统计量上。这就是讲义里讲的:
10:
On chip, compute .
输出累加器的同步更新。
这里的
12:
On chip, compute .
内层循环结束后,
13:
On chip, compute .
这一步计算 logsumexp。它把每行的 running max 和 running sum 合并成一个标量:
为什么要存
By storing softmax normalization factors from forward (size N), recompute attention in the backward from inputs in shared memory
前向传播不保存巨大的
14:
Write to HBM as the -th block of . 15: Write to HBM as the -th block of .
最后,把归一化好的输出块
- 读 HBM:各一次的
(总共约 次传输) - 写 HBM:最终的
和 - 从未写回 HBM 的:任何
的中间注意力矩阵
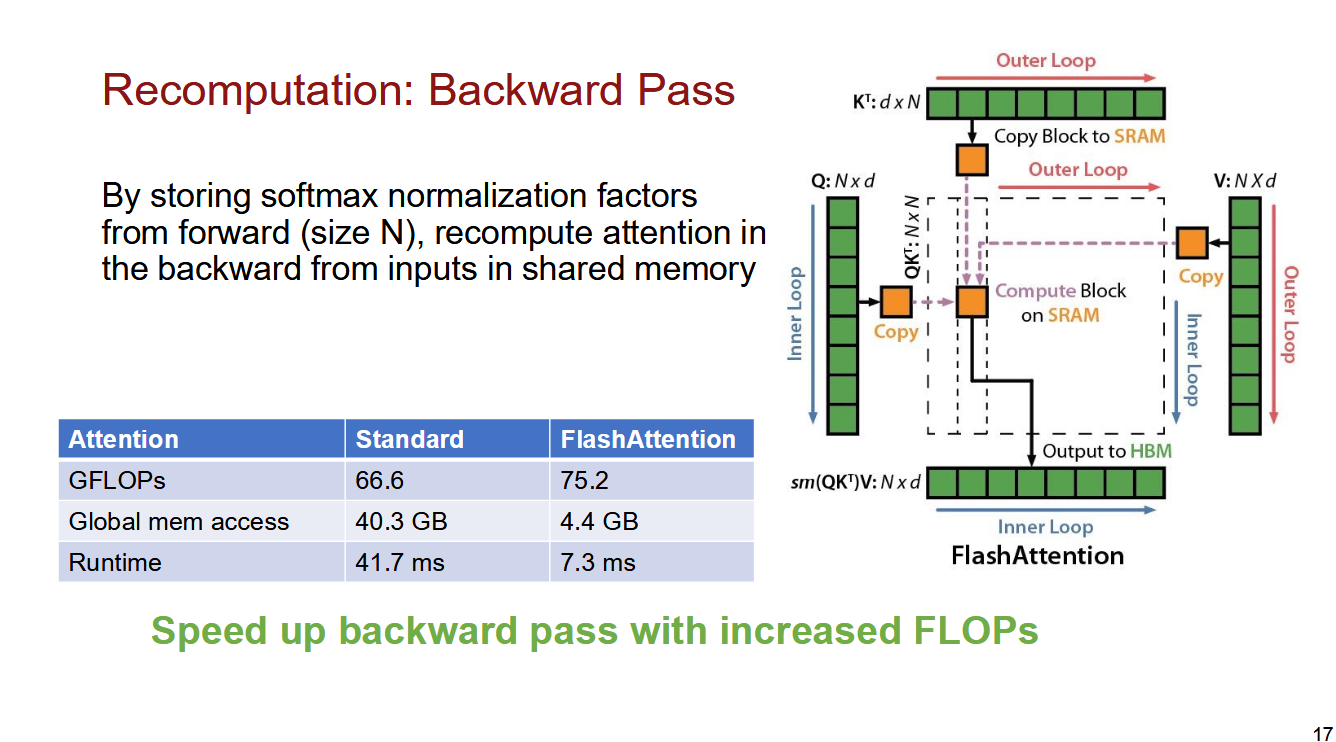
Recomputation 用于解决反向传播时的内存占用问题:
其中
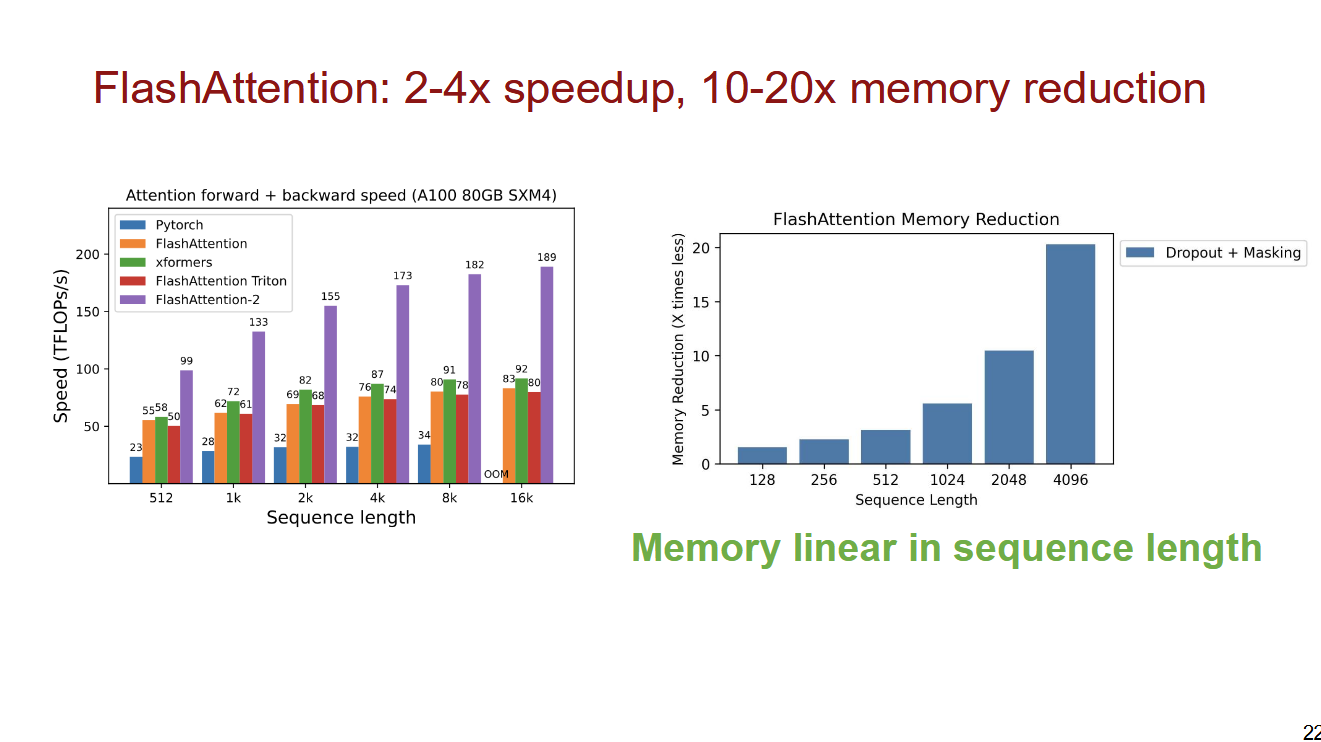
效果是 GFLOPS 虽然增加,但是 Runtime 却显著下降。
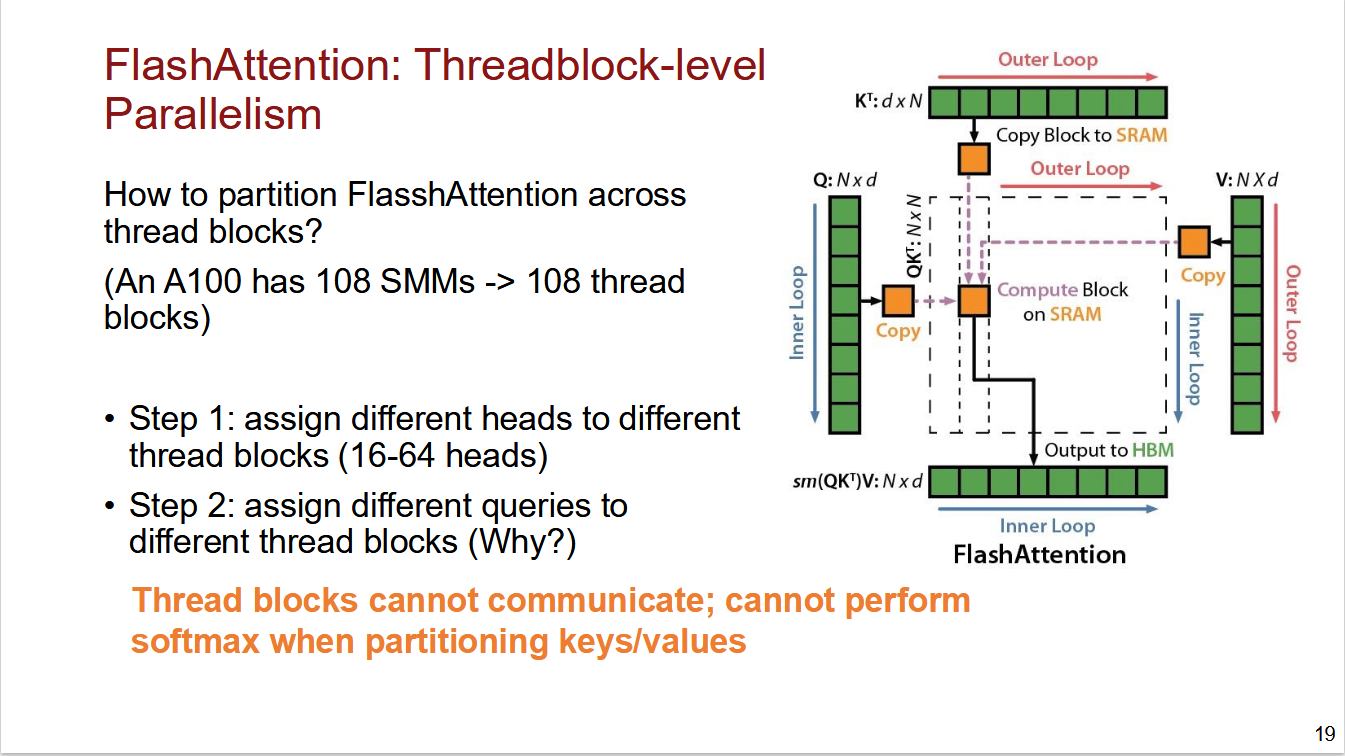
前面解决了单个 thread block 内部如何用 Tiling 和 Online Softmax 在 SRAM 上高效计算;现在我们考虑怎么把这么多 thread block 组织起来。
- 不同 head 可以直接映射到不同 thread block,典型 Transformer 有 16–64 个 head,可以直接利用数十个 SM。
- head 数量不足以填满所有 SM,需要在同一个 head 内部继续切分。此时选择按 Query 切分:每个 thread block 被分配负责一部分 query 行,该 block 把分到的
加载到 SRAM 后,顺序遍历所有的 Key/Value 块( ),用 Online Softmax 在本地维护 running max 和 running sum。处理完所有 K/V 后,该 block 即可独立完成 softmax 归一化,把属于自己的那部分输出写回 HBM。
之所以不能按 K/V 切分,是因为 softmax 的归一化是按行(Query)进行的,每个 Query 的 softmax 分母是所有 Key 的加权和。如果按 K/V 切分,不同 block 之间无法通信,就无法得到正确的归一化结果。
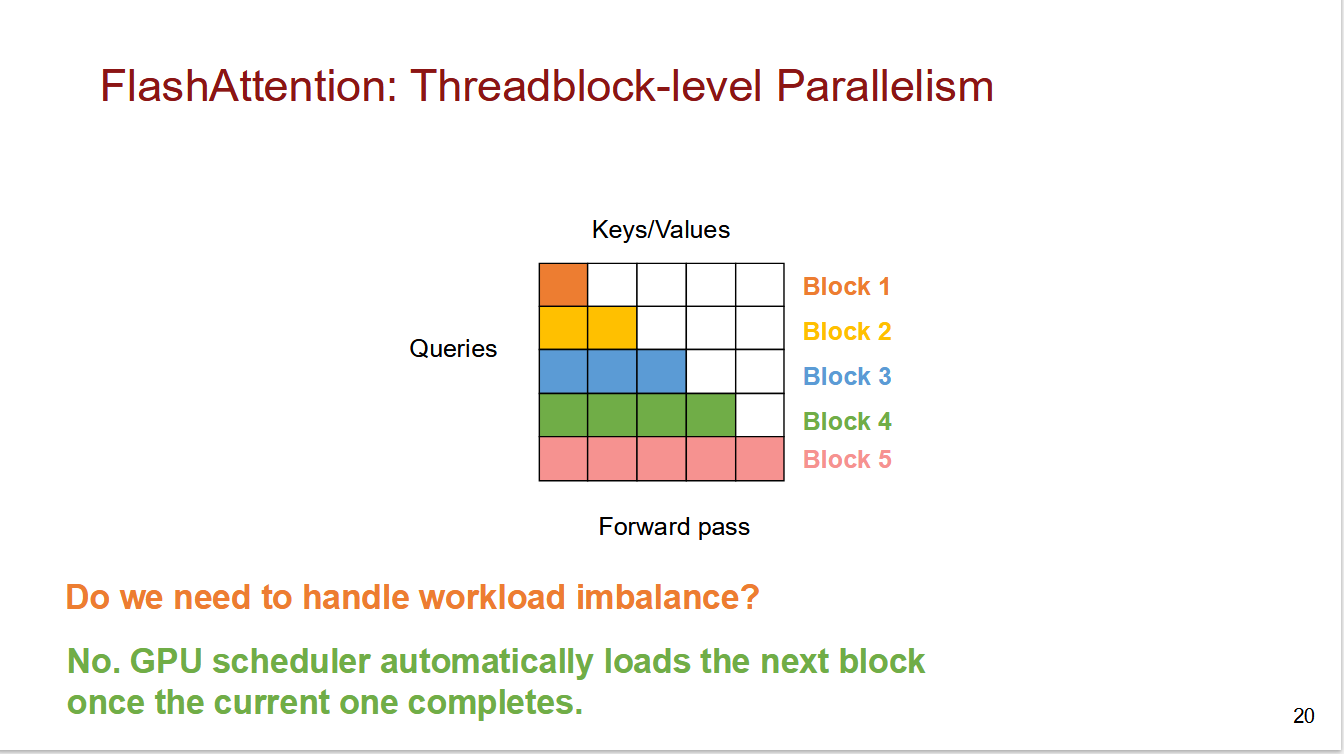
GPU 会自动管理 Block 的调度,因此无需关心不同 Block 之间的不平衡问题。
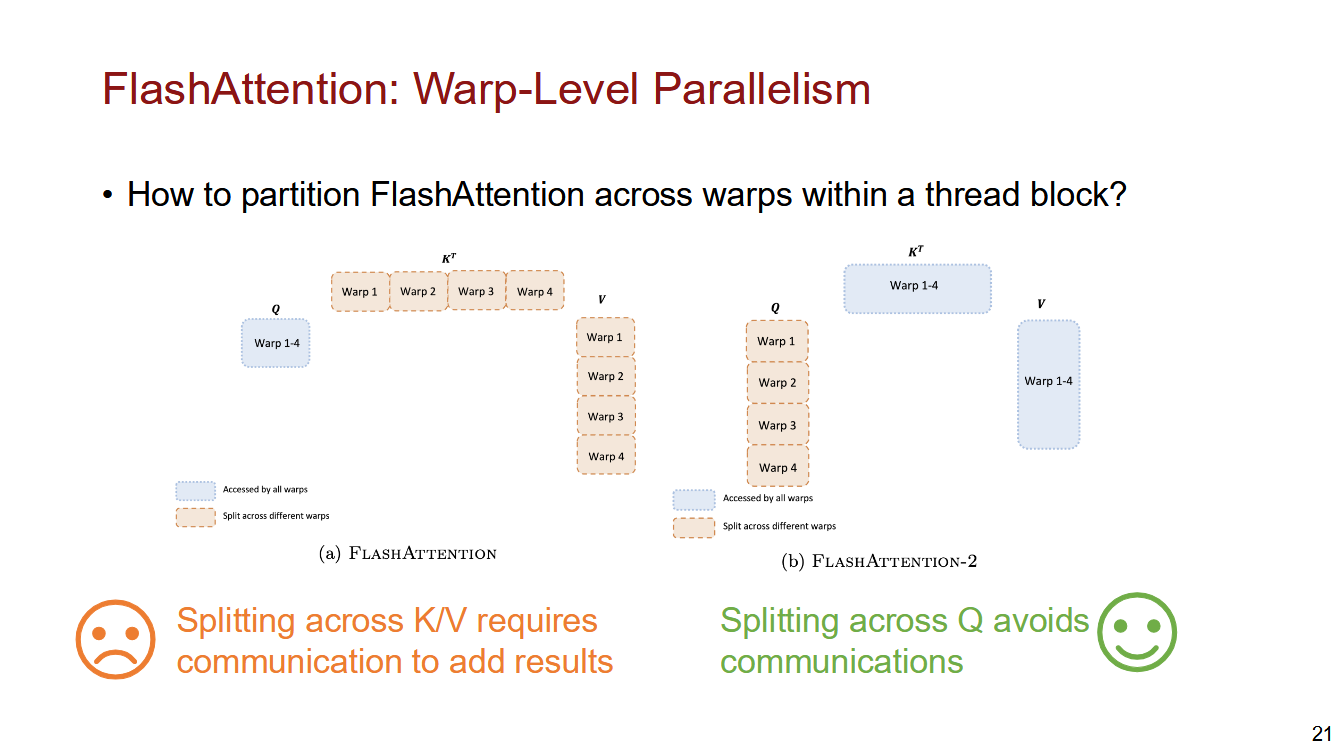
Flash Attention 2 相比 Flash Attention 1,更强调把 query 作为并行维度。在之前的 Flash Attention 1 的实现中,要得到全局正确的归一化结果,不同 warp 之间必须通过 shared memory 做跨 warp 的 reduce 操作,warp 之间要等大家都算完局部值才能继续;而在 Flash Attention 2 中,每个 warp 负责计算自己那几行 query 的完整 attention,由于不同 query 行在 softmax 上完全独立,因此不需要跨 warp 的 reduce 操作,warp 之间可以完全独立地并行计算。
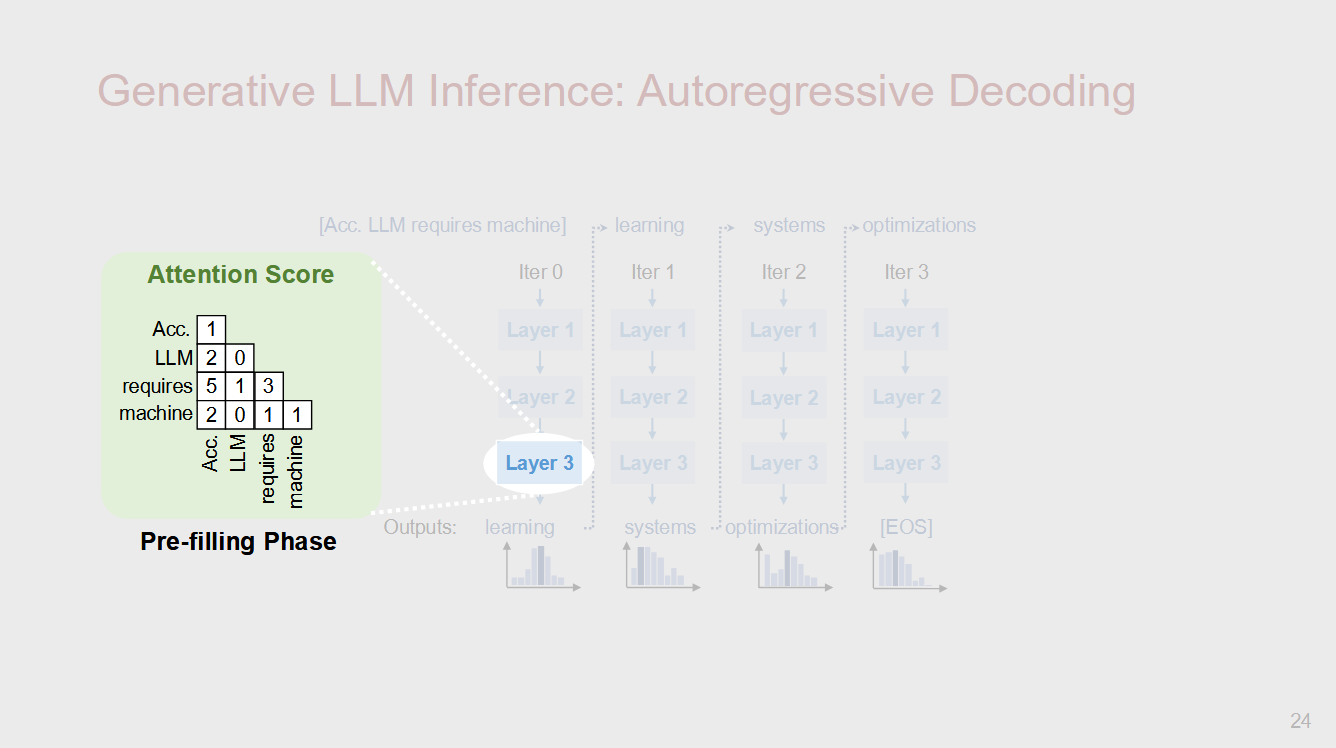
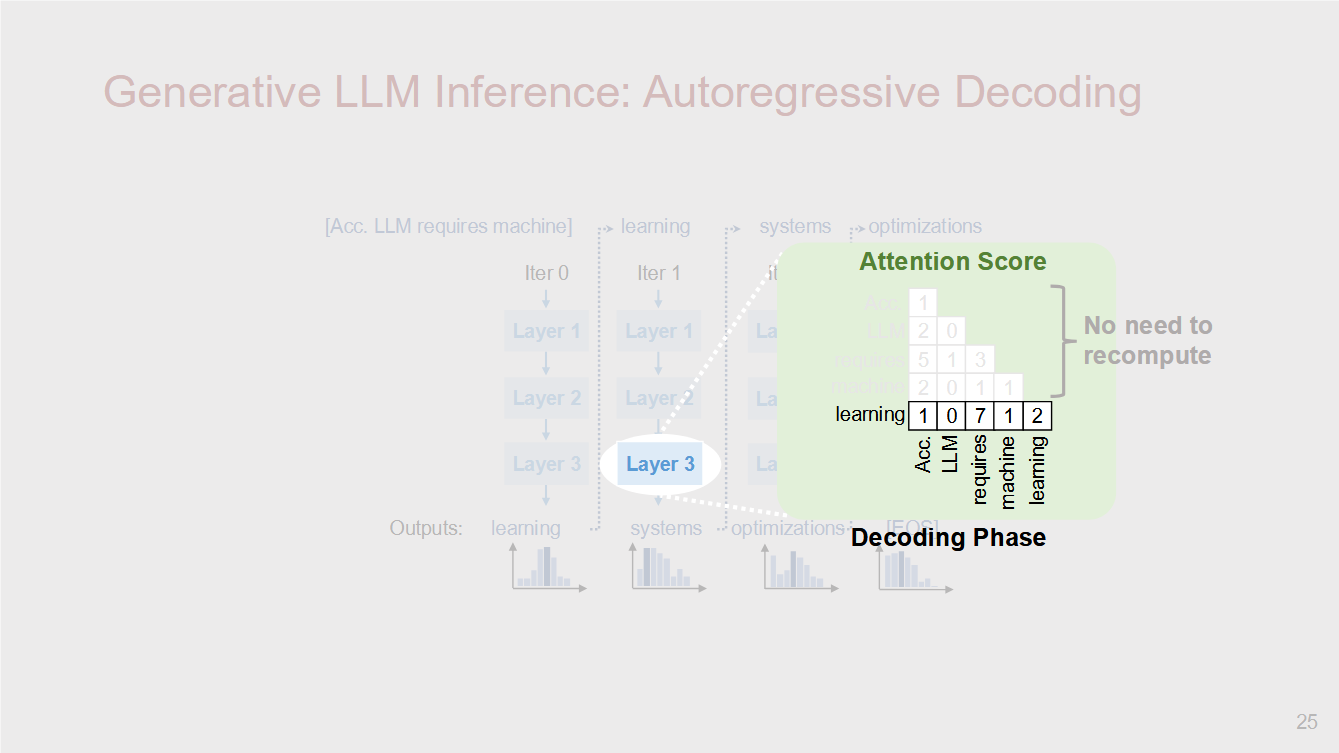
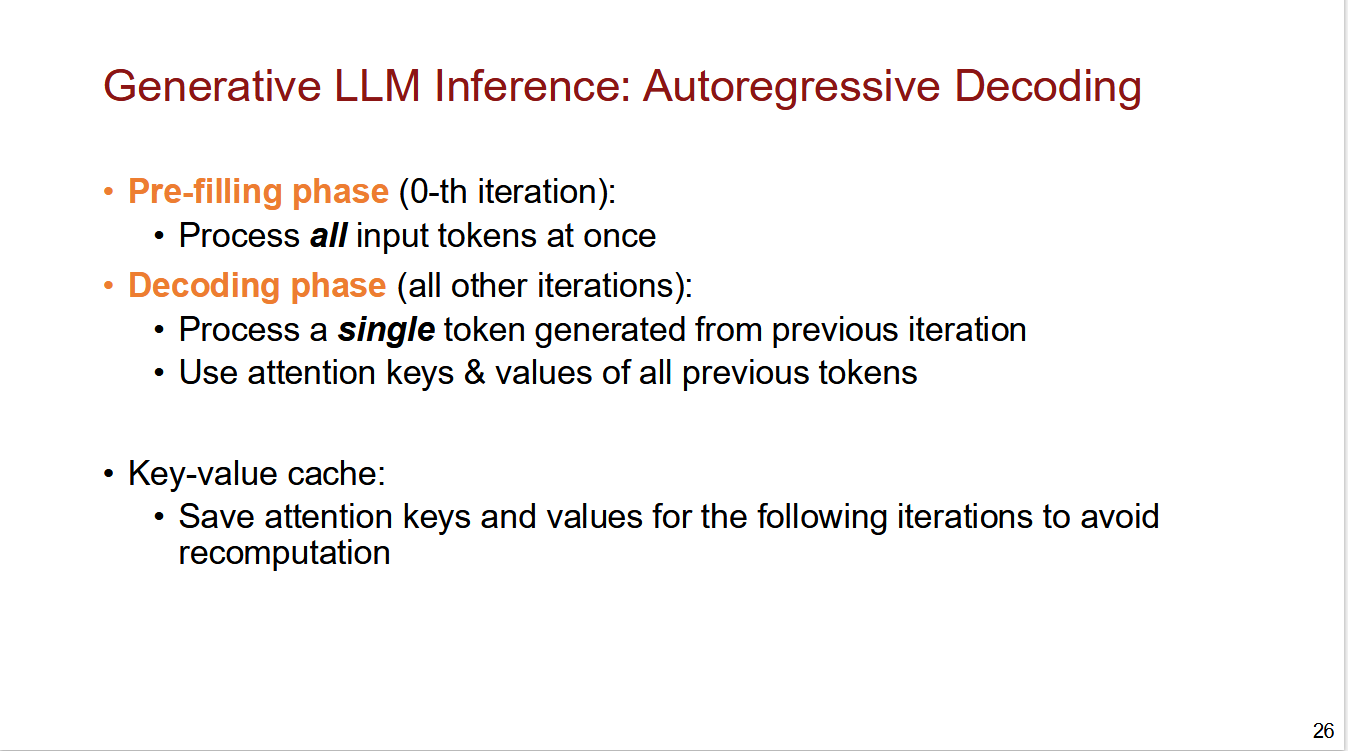
在 Decoder-Only 的架构上,prefill 阶段的 KV 可以被缓存起来,避免每次重复运算,decode 阶段只需要计算新生成的 token 对应的 Q 与缓存的 K/V 做 attention,然后把新的 K/V 追加到缓存即可,也就是 KV Cache。
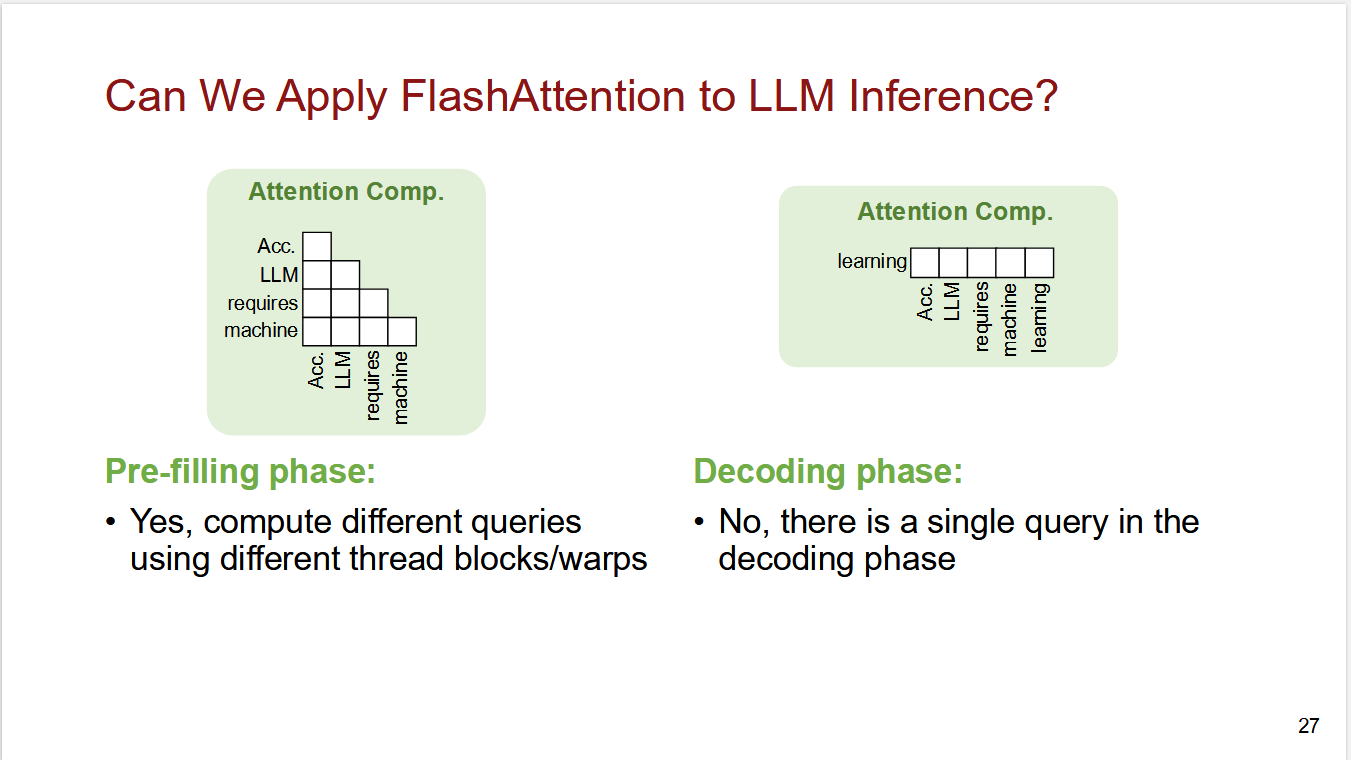
在 prefill 阶段仍然可以使用前面的 Flash Attention 方法,然而在 decode 阶段,由于每次只生成一个 token,Q 只有一行,因此不再能直接使用 Flash Attention。
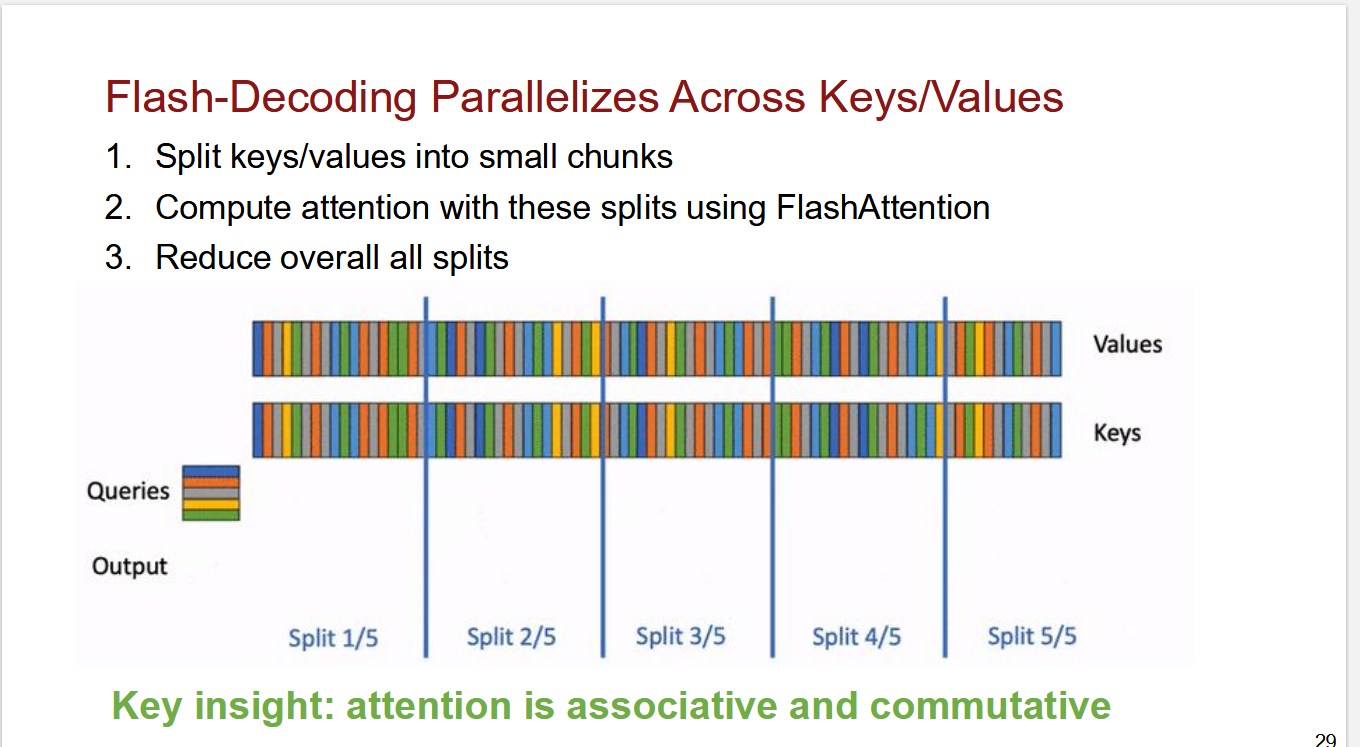
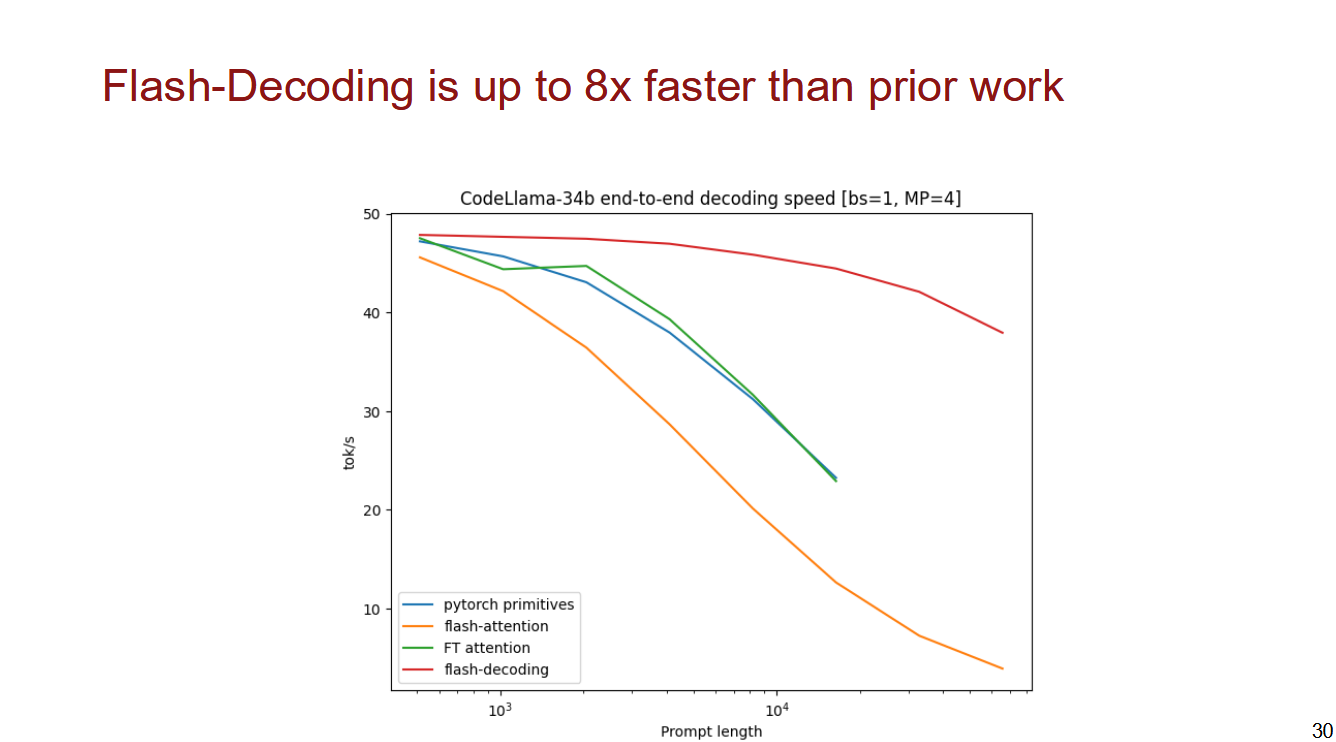
Flash Decoding:
- 把 K/V 分成若干个块;
- 对这些块通过 Flash Attention 的方法做并行地计算,也就是把每个 KV 块当作一个小型的 Flash Attention 任务来处理;
- 合并这些块的结果,得到最终的输出。